AIは文章を書かず、判定だけを返せる——Jevの確信度が、手書き205語の判定ルールを置き換える条件
2026.09.18 夕 | 株式会社NGraph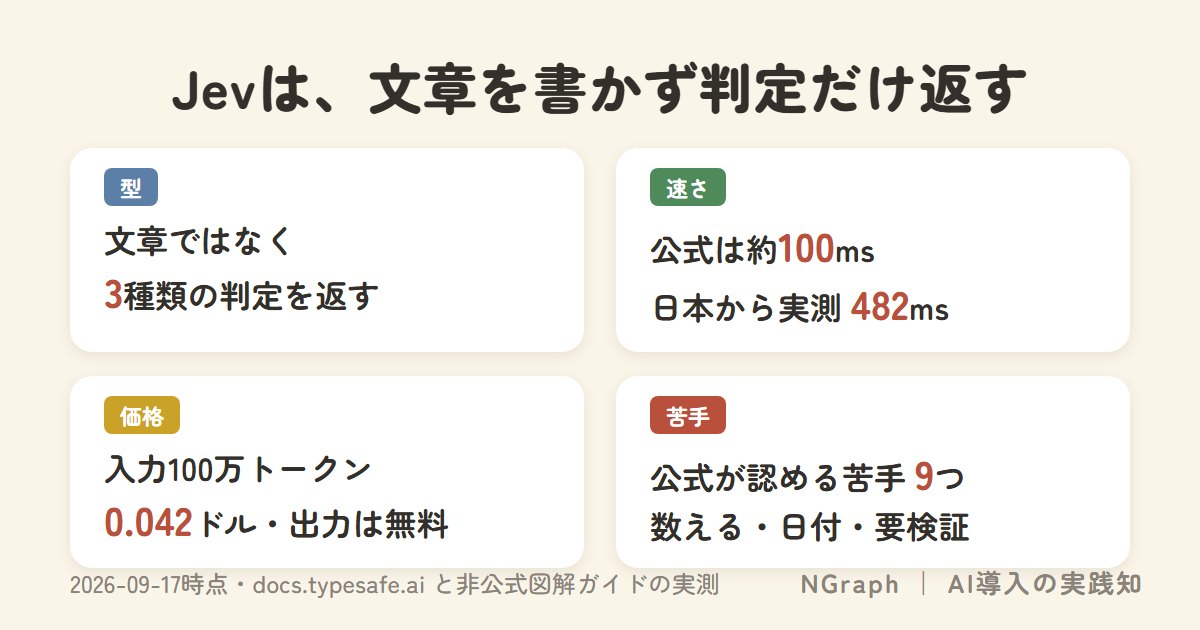
TypeSafe社のAIモデル「Jev(ジェヴ)」は、文章を書きません。渡した状況に対し、どれを選ぶか・どの程度か・YesかNoかという型のある値だけを、確率と確信度つきで返します。公式ドキュメントは価格を入力トークン100万あたり0.042ドル・出力は無料と定め、多くの応答は「約100ms」で終わるとも書いています(2026年9月17日時点)。私たちはいま、自社の飲食店向けAIコンシェルジュ「OMISEAI」で、客の質問の意図を8種類に振り分ける判定を、AIではなく手書きのキーワード205語で行っています。判定をAIに任せると型が崩れたり、自信ありげな誤答が返ったりして困った経緯があるからです。この記事でわかることは次の3つです。
・Jevが「どれか・どの程度か・YesかNoか」をどう返す仕組みか
・確信度で「自動・確認・人へ」を分ける設計の考え方
・うちの手書き205語の判定ルールを仕分けるとどうなるか
Jevとは——文章を生成せず「どれか・どの程度・YesかNoか」を確率で返す
Jevは、TypeSafe社が提供するAIモデルです。現行モデルは「jev-1.13.0」で、「jev-latest」「jev-preview」という別名も、どちらも今はこのjev-1.13.0を指しています。Jevが答えられる問いの形は3種類だけです。
| 型 | 問い | 返るもの | 上限 |
|---|---|---|---|
| Choice | 一覧から1つ選ぶ | choice・probabilities(全選択肢の確率)・confidence(確信度) | 最大255択 |
| Score | 定義した段階の上で採点する | score・probabilities・confidence | 2〜10段階 |
| Noul | ある命題が真かどうか | noul(0〜1の値)のみ | 確信度は付かない |
3つとも、AIが文章を書く代わりに、あらかじめ決めた形の値だけを返します。1回のリクエストには複数の質問を混ぜてよく、質問はすべて同じ状況に対して並列・独立に判定される仕組みです。公式ドキュメントも、質問を足しても応答時間はほとんど変わらないと説明しています。仕様の要点は、価格を含めて次の表のとおりです。価格は、AIが文章の分量を数える単位「トークン」で決まり、日本語はおおむね1文字1トークン前後が目安です。
| 項目 | 内容 |
|---|---|
| 価格 | 入力トークン100万あたり0.042ドル。出力トークンは無料 |
| レート上限 | 毎秒25万トークン・毎分1,200リクエスト。公式が「予告なく変わる」と明記 |
| 文脈の長さ | 1リクエスト64kトークン(状況+全質問の合計)。状況と最長の質問だけなら32kトークン |
| 入力 | テキストのみ。画像・音声・動画は不可 |
| 言語 | 英語が主で精度も最良。日本語などは使えるが、自分のデータで試すよう公式が求めている |
顧客が送ったやり取りでJevが学習し直すことはなく、顧客データでの個別調整もしていません。全アカウントが同じ重みを共有しています。
LLMに判定させると何が起きるか——うちは205語の手書きルールに逃げていた
私たちが運営する飲食店向けAIコンシェルジュ「OMISEAI」は、客からの最初の質問を、雑談・SNS投稿などの作成依頼・観光・店舗情報・名物・おすすめ・食事制限・その他の8種類に振り分けています。店舗情報には営業時間や予約、設備の質問が含まれます。この振り分けは、AIではなく手書きのキーワード照合で行っている作業です。
その内訳がこちらです。
手書きルールは、語を足すほど衝突が増える
キーワードは一覧の定数が店舗情報83語・雑談40語・観光16語で計139語、判定関数に直接書き込んだ分が66語で、合わせて205語です。このほかに「どこで買える」を住所案内と取り違えないための購入系の語が17語、別枠であります。手書きの代償は衝突です。「場所」が店舗情報と観光の両方に含まれていたため観光を先に判定する順番に直したり、相談の質問に住所が返る誤分類を直したりと、修正が履歴に少なくとも3件残っています。このファイルは2026年1月から7月で138回変更が記録され、語を足すほど衝突の芽が増える構図です。
自社の判定ルールを整理したい方は、無料相談で一緒に確認できます。
「型を守る」と「判定が正しい」は別——OpenAIのStructured Outputsとの違い
AIに判定させたいとき、多くの人がまず思い浮かべるのは、出力の形式を固定する機能でしょう。ChatGPTを提供するOpenAIは、AIの応答があらかじめ決めたJSONスキーマ、つまりソフト同士が値をやり取りするときの書式どおりになることを保証する「Structured Outputs」という機能を公式に用意しています。必須の項目が抜けたり、決めた選択肢に無い値を作ってしまったりする心配が要らなくなると説明されています。
形式に従うことと、選んだ値が正しいことは別の話です。形式をJSONに固定すれば、書式が崩れて読み込みに失敗するような事故は消えますが、それは値の入れ物が正しいという保証であって、中身の判定が当たっているという保証ではありません。Jevが返すのは、選んだ値だけではなく、全選択肢の確率と、それを1つの数に潰した確信度です。確信度があるかどうかが、判定結果を自動で使ってよいか人に確認してもらうかを分けられるかどうかの違いになります。ここで比べているのはStructured Outputsという機能が保証している範囲であって、OpenAIに確率を返す機能が無いという意味ではありません。
確信度で「自動/確認/人へ」を分ける——しきい値は行動のリスクで変える
ChoiceとScoreの答えには、選んだ値のほかに確信度が付きます。全選択肢の確率がどれだけ1つに偏っているかを、0から1の1つの数に潰した値です。分布が平らなほど確信度は低くなります。Noulにはこの確信度が付かず、真である確率を0から1で表した値だけが返ります。
公式ドキュメントが示す使い方の出発点は、確信度が高ければ自動で実行し、中程度なら人の確認を挟み、低ければ人に判断を回すという3段階です。公式の例示コードでは、確信度0.5未満の答えは人へ回し、残高照会のようなやり直しのきく操作はそのまま実行し、送金の承認のようなやり直しのきかない操作は、確信度が0.9を超えていても確認を挟んでから実行し、それ未満なら実行に進まず本人に確認を求めます。これは推奨値ではなく例示で、しきい値は外れたときにどれだけ困るかという行動のリスクの大きさで変えるべきだと公式は説明しています。
確率は、多数の予測をまとめて見たときに結果と噛み合うよう学習されています。ただしこれは集団で測ったときの話で、1つ1つの答えが正しいことまでは保証しません。Jevが属する「System One」という分類の名前は、心理学者ダニエル・カーネマンが呼んだ速く直感的な思考のことです。
この考え方は、確信度が低いときの対処にも表れています。米国証券取引委員会(SEC)の年次報告書を75業種に分類するクックブックでは、確信度が低ければ1段階上の広い区分に報告するという逃がし方をしています。無理に細かい区分へ押し込まず、答えられる粒度まで自分から下げる設計です。
公式が認める苦手9つ——数える・日付・計算はコード、日本語は自分で試す
そのまま任せると崩れる9つ
jaggednessは得意と苦手が凸凹していることを指す言葉で、公式ドキュメントの同名のページでは、jev-1.13が苦手とする9つの挙動を公式自身が並べて説明しています。
| 苦手 | 何が起きるか | 代わりにどうするか |
|---|---|---|
| 文字どおりに読む | 書いた質問にしか答えず、意図を汲まない | 条件を全部書き出す |
| 計算・数字 | 電卓ではない。文字数や件数を数えるのが不得意 | コードで数える |
| 日付・時刻の比較 | 日付を文字として読んでしまう | 日付の部品を取り出させ、比較はコードで行う |
| 間接参照 | 二重否定や多段の推論に弱い | 1段の問いに分解する |
| 無関係な情報が多い状況 | 状況が大きくなるほど精度が落ちる | 先にコードで絞り込む |
| 敵対的な入力 | 指示を埋め込んだ文で答えが動くことがある | 条件を明示し、配備前に試験する |
| 指示と基準の矛盾 | 与えた指示と判定基準が食い違うと崩れる | 指示と基準を揃えてから渡す |
| 構造的な整合性 | 同じ質問をNoulとChoiceで聞くと答えが揃わないことがある | 型をまたいでしきい値を使い回さない |
| 文章生成 | 生成の訓練を受けておらず、遅く品質も低い | 生成は生成用のAIに任せる |
状況が大きいほど答えが崩れやすいという現象を、公式は「無関係な情報が多い状況」の項目で説明しました。敵対的な入力については、公式は状況をデータとして扱っており、jev-1.13は既定でそれを敵対的だとは見なさない、と明記しています。つまり、状況の中に紛れ込んだ指示文に従ってしまう可能性があるということです。
足しても1にならない——恒等式が壊れる実例
構造的な整合性が崩れる例を、公式は実際の数字で示しています。同じ内容をNoulで聞くとnoul 0.22という答えが返るのに、Choiceの2択で聞くとyes 0.01・no 0.99・確信度0.97というまったく違う答えになった例があります。別の例では「返金を求めているか」が0.72、「返金以外を求めているか」が0.47で、足すと1.19になり1になりません。ある質問で調整したしきい値を、別の聞き方にそのまま使い回さないことが重要です。
公式は、避けたほうがよい使い方も4つにまとめています。コードで正確に計算できることを聞くこと、1つの質問に複数の判断を隠すこと、多段の間接参照が必要な複雑な推論、質問に要らない文脈を状況に詰め込むことです。どれも、上の9つの苦手と表裏の関係にあります。
速さと費用はどこまで再現するか——公式「約100ms」と日本からの実測482ms
公式の「約100ms」は短い入力の目安
公式ドキュメントは、多くのクエリは約100msで完了すると書いています。TypeSafe社とは無関係な第三者が公開している非公式の「Jev図解ガイド」は、2026年9月17日に自身の9ページを実際にJevで判定させ、遅延を実測しました。ページの役割判定9回と記述の裏付け確認1回、合わせて10リクエスト・121問を投げ、入力42,390トークン・出力3,095トークンを消費し、1リクエストの遅延は中央値482ms(最小447・最大715、日本からの往復込み)でした。1リクエストに12〜13問をまとめていたので、1問あたりに均すとおよそ40msです。
公式の目安「約100ms」は、短い入力の話だった
公式の「約100ms」と、この482msという中央値は、比べる母集団が違います。公式の目安は短い入力を想定したもので、長い日本語の状況と日本からの往復という条件では、その目安どおりにはならなかったと、ガイドの作者自身が記しています。差そのものを主張にせず、条件が変わると速さも変わるという事実だけを受け取るのが安全です。
質問をまとめるほど安くなる——並列とやり直しの効果
公式のクックブックには、質問を1回にまとめる効果を測った例があります。EUの個人情報保護規則GDPRを説明するWikipedia記事について13問を一度に投げたところ、1問ずつ呼び出すより12.2倍安く10.0倍速く済み、答えは変わりませんでした。
候補を1組ずつ問い直して並べ替えると、正解率が上がる
法律文書検索CLERCの課題では、40件のクエリについてキーワード検索の上位30件を1組ずつJevで並べ直したところ、最初に正解が来る割合が5%から18%へ、上位10件に正解が入る割合が38%から62%へ上がりました。まとめて安くする使い方と、問い直して並べ替える使い方は、どちらも「並列に判定できる」という同じ性質の応用です。
費用の感覚をつかむために、実測ではなく前提を置いた計算を1つだけ示します。例えば、1件の状況が500トークン、質問が12問で1リクエストあたり1,000トークンかかると置くと、月1万件の判定で1,000万トークンとなり、価格は0.42ドルです。前提を変えれば数字も変わる、あくまで一例の計算です。
うちの205語をJevで置き換えるなら——仕分けの表と、置き換えない部分
ここまでの内容を、OMISEAIの205語に当てはめてみます。判定の種類ごとに、今の方式とJev向きかどうかを並べました。
| 判定の種類 | 今の方式 | Jev向きか | 理由 |
|---|---|---|---|
| 8種類への意図分類 | 手書きキーワード205語 | 向く | 選択肢が8つに閉じた意味の判断 |
| 食事制限が含まれるか | 手書きキーワード(直書き66語の一部) | 向く | YesかNoかに閉じた判断 |
| 雑談の判定(40字以下) | 文字数のコード判定 | 向かない | 数えるのはコードの仕事 |
| 価格・日付の計算 | コード | 向かない | 計算はコードの仕事 |
| 返答文の生成 | LLM | 向かない | Jevは生成の訓練を受けていない |
Jevが効くのは、意味の判断で答えの空間が閉じている所だけ
宗教上の制約と取り違えた実例がある「食事制限が含まれるか」の判定こそ、選択肢を閉じた形で渡し確信度が低ければ人に回すという、Jevの設計を当てる第一候補です。反対に40字以下かどうかの文字数判定は、公式が苦手だと認める「数える」作業そのもので、Jevに聞く理由は乏しいところです。
断っておくと、私たちはJevをまだ試していません。ここまでの仕分けは、公式ドキュメントと自社の判定コードを突き合わせて考えた設計であり、実測ではなく、効くと言い切れるものでもありません。実際にどこまで置き換えられるかの検証は、次回に回します。
よくある失敗
- 1つの質問に2つの判断を詰める。非公式ガイドは「コストも速度も10倍以上改善した」という主張を1回の判定にかけ、裏付けあり0.85という答えを得ました。公式の抜粋は「11.5倍安く9.6倍速い」で、速度は10倍に届いていません。確信度は0.77で、他の裏付けあり項目(どれも0.99以上)より低い値でした。しきい値を0.9に置けばこの1件だけ人の確認に回せたはずです。9.6が10以上かは算数なので、コードの仕事です。
- Noulの0.5を「中程度」と読む。非公式ガイドの実測では、ある項目がNoul 0.45で返り、ゲートの0.5をわずかに下回ったために読まれない扱いになりました。0.4〜0.6あたりはYesともNoとも扱わず、質問を見直すか人に回す帯にしておくほうが安全です。
- Noulで決めたしきい値を、Choiceにそのまま使い回す。前の章で見たとおり、同じ内容でもNoulとChoiceでは答えの出方が違い、確率を足しても1になりません。型が変わればしきい値も引き直します。
- 状況に関係のない情報まで入れる。公式が苦手の1つに挙げているとおり、状況が大きくなるほど精度は落ちます。先にコードで絞り込んでから渡します。
- 英語での例をそのまま信じて、日本語で試さない。公式は、日中韓を含む言語の扱いは英語と同等ではないと明記しており、自分のデータで試して確信度を見るよう求めています。
判定まわりの設計を相談したい方は、無料相談・無料AI診断からどうぞ。
まとめ
Jevは、文章を書く代わりに、どれか・どの程度か・YesかNoかという型のある値を確率と確信度つきで返すAIです。使い方の出発点は、確信度が高ければ自動、中程度なら確認、低ければ人へという3段階で、しきい値は行動のリスクに応じて変えます。公式自身が9つの苦手を認めており、数える・日付を比べる・文章を作るといった作業はコードや別のAIに任せたほうが安全です。速さと費用の目安も、条件次第で公式の数字どおりにはならないことを非公式の実測が示しています。私たちはOMISEAIで、判定をAIに任せず手書きの205語に頼ってきました。Jevはまだ試していませんが、判定を手書きルールで抱えている会社は、まず自社の判定を意味の判断・計算・生成に仕分けるところから始められます。
よくある質問
Jevとは何ですか?
TypeSafe社が提供するAIモデルで、文章を生成する代わりに「どれか」「どの程度か」「YesかNoか」を確率と確信度つきの値で返します。現行モデルはjev-1.13.0です。
ChatGPTやClaudeの代わりになりますか?
なりません。Jevは文章を生成する訓練を受けておらず、公式ドキュメントも文章生成を苦手の1つに挙げています。返答文の作成は、これまでどおり生成用のAIが担います。
料金はいくらですか?
入力トークン100万あたり0.042ドルで、出力トークンは無料です。2026年9月17日時点の公式ドキュメントの価格です。
日本語は使えますか?
使えますが、公式は英語が主で精度も英語が最良だと明記しており、日中韓を含む言語は英語と同等ではないとしています。自分のデータで試し、確信度を見ながら使うことが求められます。
確信度とは何ですか?
ChoiceとScoreの答えに付く0から1の値で、全選択肢の確率がどれだけ1つに偏っているかを表します。高ければ自動で実行、中程度なら確認、低ければ人へ回すという使い方が公式の出発点です。Noulには確信度が付きません。
うちのような小さな会社で使い道はありますか?
答えの選択肢が閉じた意味の判断であれば使い道はあります。客の質問を8種類に振り分ける判定や、食事制限が含まれるかどうかの判定がこれにあたります。文字数のような計算はコードのまま、返答文の作成は生成AIのままにしておくのが安全です。
セキュリティは大丈夫ですか?
公式ドキュメントは、顧客のやり取りでJevを学習し直すことはなく、顧客データでの個別調整も行わないと説明しています。全アカウントが同じ重みを共有する形です。
・TypeSafe AI「Models」(docs.typesafe.ai・2026年9月17日時点)
・TypeSafe AI「Jev 1.13 jaggedness」(docs.typesafe.ai)
・TypeSafe AI「Confidence」(docs.typesafe.ai)
・TypeSafe AI「Introduction」(docs.typesafe.ai)
・TypeSafe AI「Parallel questions」(docs.typesafe.ai クックブック)
・TypeSafe AI「Re-ranking」(docs.typesafe.ai クックブック)
・「Jev 図解ガイド」(非公式・TypeSafe社とは無関係の第三者による実測。2026年9月17日実施)
・OpenAI「Structured model outputs」(platform.openai.com)
・あわせて読む:AIは指示を一定確率で無視する——「プロンプトを増やす」が対策にならない理由と、仕組みで塞ぐ方法(当ブログ)
・あわせて読む:一番強いAIに全部やらせるのが一番高い——NVIDIAが示したコスト3分の1と、中小企業での振り分け方(当ブログ)
・あわせて読む:社員は会社より先にAIを使い始める——シャドーAI関与の侵害が20%から43%へ、禁止と研修が効かない理由(当ブログ)